Workshops pre Data Saturday Madrid 2026 (SQLSaturdayMadrid)

About this Event
Anunciamos los workshops del evento
Otro año más el Data Saturday Madrid trae los MEJORES workshops de Data + AI que podéis encontrar en España con los mejores MVPs y ponentes nacionales e internacionales.
Añadimos así 15 espectaculares workshops que se impartiran el Jueves 5 Noviembre (5 workshops por la tarde) y Viernes 6 Noviembre (10 workshops durante el dia), dos días antes del evento Data Saturday Madrid. Workshops de una altísima calidad y profundidad técnica orientados a varios perfiles. Una oportunidad irrepetible de acceder a conocimiento de mucho valor.
Los workshops se dictarán en horarios de 17:30 PM a 19:30PM (5 workshops Jueves 5 Nov), 10AM a 14PM (4 workshops Viernes 6 Nov) o 15:30PM a 19:30PM horas (5 workshops Viernes 6 Nov) en las instalaciones del NTT DATA UNIVERSITY, Camino Fuente de la Mora, 1. 28050 Madrid Madrid España(sitio diferente al sitio del evento del Sábado). Así os damos la oportunidad de completar vuestro viaje apuntandoos a varios de ellos segun vuestro learning-path y llevando vuestro conocimiento al siguiente nivel.
Puede inscribirte en alguno de los workshops tengas o no tengas entrada para el evento del sábado, sin embargo, aquellas personas que no tengan entrada del Sábado y se inscriban en alguno de los workshops tendrán incluida la entrada del Sábado (hasta cubrir cupo extra).
Resumen de Workshops confirmados:
Jueves 5 Noviembre (25 € + tasas eventbrite)
Tarde (17:30PM - 19:30PM)
- Build Your Business Context with Microsoft Fabric (2h) por Edgar Cotte (Product Manager at Microsoft)
- Más allá de Power BI: crea tu primera aplicación con Microsoft Fabric (2h), por Iván Arribas (Microsoft MVP)
- Del dato al agente: construye tu Data Agent en Microsoft Fabric y llévalo a Foundry (2h), por Roberto Navarro (Microsoft MVP) y Miguel Ocaña San Julián
- Analysing and Resolving Deadlocks (2h), por Erland Sommarskog - Idioma Inglés
- De entrenar a aprender en contexto: Tabular Foundational models en profundidad (2h), por Pau Sempere (Microsoft MVP)
Viernes 6 Noviembre (50 € + tasas eventbrite)
Mañana (10AM - 14PM)
- Dime qué commiteas y te diré quién eres (4h), por Mar Lizana (Microsoft MVP) y Adrián Rincón López
- DAX a máxima velocidad: Fusion, Callbacks y el tiempo bien modelado (4h), por Miguel Egea
- Crea tu mascota con IA y MicroHarness (4h), por Alejandro Almeida (Microsoft MVP)
- T-SQL desde cero: aprende SQL jugando (4h), por Roberto Carrancio (Microsoft MVP) y David Martínez de Frutos
- ¿Quién se está comiendo mi capacidad? Taller práctico de optimización de Microsoft Fabric (4h), por Toni Ferrà
Tarde (15:30PM - 19:30PM)
- Construyendo nuestro primer Lakehouse en Microsoft Fabric (4h), por Ana Maria Bisbé (Microsoft MVP),Nelson López (Microsoft MVP) y Diana Aguilera Reyna (Microsoft MVP)
- Visuales que enamoran en Power BI: de lo nativo al informe como código (4h), por Inés Pascual (Microsoft MVP) y Sara Lozano (Microsoft MVP)
- De modelos a IA gobernada: AI Gateways con Azure API Management, Microsoft Foundry y Databricks (4h), por Rodrigo Liberoff (Microsoft MVP) y Borja Piris de Castro (Microsoft MVP)
- SQL Server Performance Optimization: From Root Cause Analysis to Sustainable Solutions (4h), por Torsten Strauß- Idioma Inglés
- La experiencia como producto (4h), por Antonio Soto (Microsoft MVP), Miguel Egea y Eladio Rincón
Detalles de los Workshops confirmados:
Jueves 5 Noviembre (25 € + tasas eventbrite)
Tarde (17:30PM - 19:30PM)
Construye el contexto de tu negocio con Microsoft Fabric (2h) por Edgar Cotte (Product Manager at Microsoft)
Descubre cómo Microsoft Fabric IQ Ontology convierte datos fragmentados en conocimiento empresarial conectado. A través de un escenario práctico, los participantes aprenderán a modelar, conectar, enriquecer y razonar sobre sus datos, creando un contexto compartido que ayuda a los agentes de IA a comprender mejor el negocio.
Más allá de Power BI: crea tu primera aplicación con Microsoft Fabric (2h), por Iván Arribas (Microsoft MVP)
Las Microsoft Fabric Apps permiten dar un paso más allá del dashboard tradicional y convertir nuestros datos en experiencias orientadas a resolver necesidades reales de negocio.
En este workshop construiremos paso a paso una Fabric App, partiendo de datos almacenados en Microsoft Fabric hasta crear una aplicación que combine información, visualizaciones e interacción con el usuario.
El objetivo es que, en solo dos horas, los asistentes descubran cómo pasar del dato al informe y del informe a una aplicación de negocio completa utilizando Microsoft Fabric.
Del dato al agente: construye tu Data Agent en Microsoft Fabric y llévalo a Foundry (2h), por Roberto Navarro (Microsoft MVP) y Miguel Ocaña San Julián
En este workshop descubrirás cómo convertir tus datos en una experiencia de IA capaz de entender preguntas, razonar sobre la información y generar respuestas útiles. Construiremos un Data Agent en Microsoft Fabric y, en la segunda parte, lo conectaremos con Microsoft Foundry para llevarlo a escenarios de agentes más avanzados. Un recorrido práctico de principio a fin para ver cómo pasar de datos a agentes inteligentes.
Analysing and Resolving Deadlocks (2h), por Erland Sommarskog - Idioma Inglés
About every developer and DBA has to deal with deadlocks in their work. This session starts with a brief introduction to define what a deadlock is. The next step is to learn how you get information about deadlocks, how to get hold of the deadlock XML. From here I proceed to explain how to read that XML, and particularly what are the important things you should look for.
Before moving on how to resolve deadlocks, there is an interlude with a recap on the most important locking concepts in SQL Server, since without understanding about the locking mechanisms in SQL Server, it will be difficult to analyse and resolve deadlocks. This includes discussion of the isolation levels, and in this phase we will also learn some ways to avoid deadlocks.
The last part of the session discusses various ways on how you can prevent deadlocks. Sometimes it is not entirely possible or feasible to entirely prevent deadlocks, and the session discusses which mitigating actions you can take in these cases. And not the least you will learn why deadlock retry is not something you should implement as a matter of routine.
De entrenar a aprender en contexto: Tabular Foundational models en profundidad (2h), por Pau Sempere (Microsoft MVP)
Los LLMs cambiaron la pregunta en NLP: de «¿cómo entreno un modelo para esta tarea?» a «¿puede un modelo preentrenado resolverla a partir del contexto?». Los Tabular Foundation Models plantean el mismo cambio sobre los datos estructurados.
En esta sesión abriremos la caja de TabPFN-3.5 y NVIDIA Kumo Tabular. Veremos cómo se preentrenan con millones de tablas sintéticas, por qué equivalen a una inferencia bayesiana aproximada y cómo un transformer aprende a razonar sobre celdas, columnas y filas para predecir sin actualizar sus pesos.
Después, los pondremos a prueba en directo frente a LightGBM, CatBoost y redes neuronales en clasificación, regresión y forecasting. No nos quedaremos en el accuracy: miraremos también calibración, intervalos, distribuciones predictivas, latencia y coste. Aprenderemos a leer los benchmarks con espíritu crítico y, sobre todo, intentaremos romperlos con datos más grandes, extrapolación y cambios temporales.
Terminaremos con un marco de decisión práctico y una pregunta abierta: ¿estamos viviendo el momento GPT del Machine Learning tabular?
Viernes 6 Noviembre (50 € + tasas eventbrite)
Mañana(10AM - 14PM)
Dime qué commiteas y te diré quién eres (4h), por Mar Lizana (Microsoft MVP) y Adrián Rincón Lópezs
Buenos días. ¿Tiene usted un minuto para hablar de Git? No se asuste, no venimos a venderle nada. Solo queremos preguntarle una cosa: ¿cuántas carpetas tiene ahora mismo con nombres como Ventas_final, Ventas_final_v2 y Ventas_final_ESTE_SÍ? Lo sabíamos. Hay salvación.
Git lleva años siendo el pan de cada día de quienes programan, pero a la gente de Power BI nadie nos invitó a la fiesta. Hasta ahora. Con Microsoft Fabric, el control de versiones ya no es opcional, y en este workshop de 4 horas empezamos desde cero absoluto. No hace falta saber programar ni haber abierto nunca una terminal.
Saldrás con un workspace versionado, un flujo de trabajo que puedes aplicar el lunes en tu equipo y la tranquilidad de saber que ningún cambio se pierde nunca más. Y, quién sabe, puede que acabes llamando a la puerta de tus compañeros para hablarles de Git.
DAX a máxima velocidad: Fusion, Callbacks y el tiempo bien modelado (4h), por Miguel Egea
¿Tus informes tardan segundos en responder y no sabes dónde mirar? En este workshop vamos a abrir el capó del motor de DAX para entender por qué una medida es lenta y cómo hacerla rápida.
Veremos cómo el motor optimiza (o no) tus consultas mediante DAX Fusion, qué son los callbacks y por qué pueden arruinar el rendimiento sin que te des cuenta. Hablaremos de cómo una dimensión de tiempo bien diseñada marca la diferencia, y exploraremos técnicas que combinan DAX y relaciones (incluyendo USERELATIONSHIP) para reducir el trabajo del motor.
Esto no es una charla para mirar: es un workshop con ejercicios prácticos. Tendrás modelos y medidas reales, las medirás, las romperás y las dejarás volando, paso a paso.
Te llevarás:
Un método para diagnosticar medidas lentas.
Criterio para saber qué patrones de DAX evitar y cuáles favorecer.
Técnicas de modelado de tiempo que mejoran el rendimiento.
Ejercicios y modelo de ejemplo para seguir practicando.
Crea tu mascota con IA y MicroHarness (4h), por Alejandro Almeida (Microsoft MVP)
¿Qué necesita una mascota virtual para tener personalidad, recordar nuestras preferencias y realizar acciones? En este taller práctico de cuatro horas construiremos una mascota con IA utilizando Python, MicroHarness y Microsoft Agent Framework.
Partiremos de un proyecto base y lo transformaremos paso a paso en un agente con identidad propia. Definiremos su nombre, personalidad y reglas de comportamiento; añadiremos herramientas para consultar y actualizar su estado; e incorporaremos memoria para mantener continuidad entre conversaciones. La mascota será el hilo conductor para comprender cómo funcionan el contexto, las herramientas y las sesiones de un agente.
También introduciremos aprobación humana para una acción controlada y revisaremos las trazas de ejecución para comprobar qué herramientas se han utilizado y qué información se ha guardado. Finalmente, interactuaremos con nuestra mascota desde una interfaz web mediante FastAPI y AG-UI.
El recorrido combinará explicaciones breves, ejercicios guiados y retos de personalización. Compararemos la implementación didáctica de MicroHarness con sus extensiones nativas de Microsoft Agent Framework para entender cómo encajan las distintas responsabilidades.
Al finalizar, cada participante tendrá un prototipo local de mascota conversacional con personalidad, estado persistente y herramientas propias, además de una base que podrá ampliar para crear otros agentes.
Dirigido a desarrolladores y profesionales de datos con conocimientos básicos de Python. No se requiere experiencia previa con Microsoft Agent Framework.
Requisitos: portátil con Python 3.10 o superior, Git y un editor como Visual Studio Code. Para ejecutar las conversaciones con IA será necesario acceso a un despliegue de Azure OpenAI o a un endpoint compatible con OpenAI. Las instrucciones de preparación y configuración se facilitarán antes del taller.
T-SQL desde cero: aprende SQL jugando (4h), por Roberto Carrancio (Microsoft MVP) y David Martínez de Frutos
¿Nunca has escrito una consulta SQL o apenas estás empezando? Este workshop está pensado para aprender T-SQL desde cero y, sobre todo, para practicarlo.
Comenzaremos con las bases del lenguaje, partiendo de un SELECT sencillo y avanzando progresivamente por filtros, ordenación, agregaciones, relaciones entre tablas y otras herramientas que nos permitan empezar a obtener información útil de una base de datos.
Durante la primera parte combinaremos pequeñas explicaciones teóricas con ejercicios prácticos guiados. No se trata de memorizar sintaxis, sino de entender cómo pensar una consulta y aprender a construirla paso a paso.
Después del descanso cambiaremos completamente el formato. Los asistentes tendrán que utilizar lo aprendido para enfrentarse al Cluedo SQL: un crimen, una base de datos llena de pistas y un único objetivo, descubrir qué ocurrió utilizando consultas T-SQL.
Terminaremos resolviendo el caso entre todos, revisando las distintas consultas utilizadas y viendo cómo podemos llegar a una misma respuesta siguiendo caminos diferentes.
Un workshop práctico para perderle el miedo a SQL y salir escribiendo tus propias consultas.
¿Quién se está comiendo mi capacidad? Taller práctico de optimización de Microsoft Fabric (4h), por Toni Ferrà
Tu capacidad de Fabric va al límite, llegan los avisos de throttling y nadie sabe quién tiene la culpa. En este taller práctico aprenderás a investigarlo como un detective: con datos, método y las herramientas adecuadas. Empezaremos por entender cómo se consume una capacidad (CU, smoothing, bursting, throttling) y a leer de verdad la Fabric Capacity Metrics app. Después bajaremos al detalle con Log Analytics, para encontrar las consultas y refrescos que más pesan, y con las API de Fabric y Power BI, para inventariar y automatizar la vigilancia. La segunda mitad está dedicada a casos reales encontrados en clientes: qué síntomas había, cómo se localizó al culpable y qué se cambió para reducir el consumo. Te llevarás notebooks, consultas KQL y una lista de comprobación para aplicar el lunes en tu propia capacidad.
Viernes 6 Noviembre (50 € + tasas eventbrite)
Tarde(15:30PM - 19:30PM)
Construyendo nuestro primer Lakehouse en Microsoft Fabric (4h), por Ana Maria Bisbé (Microsoft MVP),Nelson López (Microsoft MVP) y Diana Aguilera Reyna (Microsoft MVP)
El Lakehouse es una de las piezas fundamentales de Microsoft Fabric, pero ¿qué es realmente un Lakehouse?, ¿cómo almacena los datos?, ¿en qué se diferencia de un Data Lake o un Data Warehouse? y, sobre todo, ¿cómo podemos utilizarlo para construir una solución analítica?
En este workshop de 4 horas nos centraremos en entender con calma el Lakehouse de Microsoft Fabric y aprenderemos a utilizarlo construyendo paso a paso una solución desde cero.
Comenzaremos por sus fundamentos: OneLake, archivos Parquet, tablas Delta y las diferentes formas de acceder y trabajar con los datos almacenados en un Lakehouse.
A partir de ahí construiremos una arquitectura Medallion, recorriendo las capas Bronze, Silver y Gold y entendiendo qué función cumple cada una, cómo organizar nuestros datos y qué decisiones debemos tomar en cada etapa.
Durante el workshop veremos:
* ¿Qué es un Lakehouse y qué problemas intenta resolver?
* Lakehouse, Data Lake y Data Warehouse: similitudes y diferencias.
* Cómo encajan OneLake, Parquet y Delta Lake.
* Cómo se organizan físicamente los datos dentro de un Lakehouse.
* Cómo cargar y explorar datos.
* Cómo transformar datos utilizando notebooks y Spark.
* Cómo diseñar las capas Bronze, Silver y Gold.
* Cómo implementar paso a paso una arquitectura Medallion.
* Cómo consumir los datos que hemos preparado.
* Cómo utilizar agentes de IA como apoyo durante la implementación y para validar nuestra solución.
La idea es no limitarnos a utilizar el Lakehouse como una caja negra. Queremos entender qué ocurre con nuestros datos desde que llegan a Fabric hasta que están preparados para ser consumidos.
Al finalizar el workshop, los asistentes habrán construido su propio Lakehouse y tendrán una base sólida para comenzar a diseñar soluciones de datos en Microsoft Fabric.
Visuales que enamoran en Power BI: de lo nativo al informe como código (4h), por Inés Pascual (Microsoft MVP) y Sara Lozano (Microsoft MVP)
¿Tus informes de Power BI tienen datos geniales pero no terminan de impactar? Somos Sara e Inés y venimos a enseñarte todos nuestros trucos de visualización 😍📊
Primero trabajaremos con los visuales nativos y después nos pasaremos a VS Code para crear y editar visuales con IA y skills de authoring, tratando el informe como código (PBIP/PBIR).
Será una sesión de manos a la obra, de compartir trucos y aprender td@s junt@s así que trae tu portátil, tus dudas y tus ganas de cacharrear. Saldrás con ideas que podrás aplicar al día siguiente en tus propios informes. 💜
De modelos a IA gobernada: AI Gateways con Azure API Management, Microsoft Foundry y Databricks (4h), por Rodrigo Liberoff (Microsoft MVP) y Borja Piris de Castro (Microsoft MVP)
Construir una aplicación con Inteligencia Artificial puede ser relativamente sencillo. El verdadero reto aparece cuando queremos llevarla a un entorno empresarial y necesitamos controlar quién accede a los modelos, controlar el consumo, observar su comportamiento, evaluar sus respuestas y aplicar políticas de gobierno de forma consistente.
En este workshop práctico, descubriremos el papel de los AI Gateways como pieza fundamental para gobernar soluciones de IA generativa. Partiremos de los conceptos básicos y compararemos las aproximaciones de Azure API Management (APIM) como AI Gateway, las capacidades de Microsoft Foundry, y en contraposición el Databricks Unity Gateway; entendiendo qué aporta cada tecnología y cómo pueden complementarse dentro de una misma arquitectura empresarial.
A través de ejercicios prácticos avanzaremos desde el consumo directo de un modelo hacia una arquitectura gobernada mediante un AI Gateway, explorando conceptos como control de acceso, políticas, gestión del tráfico, seguridad y observabilidad.
También introduciremos Red Teaming y Evaluations para analizar y evaluar el comportamiento de nuestras soluciones de IA antes de llevarlas a producción.
Exploraremos además la importancia de la trazabilidad y la observabilidad, viendo cómo recopilar y analizar trazas de las interacciones con modelos y aplicaciones de IA. Unity Gateway, por ejemplo, dispone de una tabla unificada de trazas basada en OpenTelemetry para registrar la actividad que atraviesa sus servicios.
Finalmente, conectaremos todas las piezas para entender su relación, analizando cómo diseñar una arquitectura en la que modelos y servicios de IA puedan consumirse de manera segura, observable, evaluable y gobernada.
SQL Server Performance Optimization: From Root Cause Analysis to Sustainable Solutions (4h), por Torsten Strauß- Idioma Inglés
A slow query is often only the visible symptom of a deeper problem. Inefficient access paths, parameter-sensitive execution plans, excessive memory grants, and blocking can interact in ways that make isolated fixes unreliable. This full-day, hands-on PreCon teaches you how to trace these symptoms to their root causes and validate improvements under concurrent load.
The workshop combines practical troubleshooting experience with realistic, reproducible lab scenarios. Each investigation follows a structured process: establish a baseline, collect evidence, explain the engine’s behavior, compare possible solutions, and measure the results.
Using execution plans, Query Store, DMVs, Extended Events, and controlled load tests, you will investigate expensive scans, plan regressions, memory spills, worker pressure, and blocking. You will evaluate rowstore and columnstore indexing strategies, examine how index and heap structures affect resource consumption, and explore the relationship between parallelism and workload concurrency.
Throughout the day, we challenge fixes that appear successful in isolation. What happens when a forced plan benefits one parameter value but penalizes another? Can eliminating a spill increase memory-grant waits for competing queries? When does an index resolve blocking, and when do lock escalation or transaction isolation require a different approach? You will compare these alternatives and assess their performance and operational trade-offs.
By the end of the workshop, you will have a repeatable troubleshooting methodology and practical diagnostic scripts for your own investigations. You will be equipped to validate changes across CPU, I/O, memory, response time, and concurrency, with principles applicable to SQL Server and Azure SQL environments - helping you improve workload stability, use resources more efficiently, and identify opportunities to reduce cloud resource requirements.
La experiencia como producto (4h), por Antonio Soto (Microsoft MVP), Miguel Egea y Eladio Rincón
Entre los tres sumamos más de 75 años construyendo plataformas de datos, de los primeros data warehouses a los lakehouses de hoy en Microsoft Fabric. Hemos visto qué hace que un proyecto no solo llegue a producción sino que siga vivo años después, y qué hace que muera en el tercer sprint. Y ya os adelantamos que nunca es la tecnología: son las convenciones, la estructura, la calidad del dato y quién responde de cada pieza.
En este workshop convertimos esas lecciones en un marco de trabajo reutilizable para proyectos de ingeniería de datos y analítica en Fabric y PowerBI: estructura de repositorio, arquitectura medallón, notebooks y librerías parametrizadas, pruebas de datos, documentación como código y despliegue con Git y pipelines. Sobre ese marco añadimos la IA Generativa: cómo darle a un asistente de código el contexto, las reglas y las plantillas necesarias para que genere código que respete tus estándares en lugar de inventarse los suyos.
¿Y el Sábado? ¡ El evento Data Saturday Madrid!:
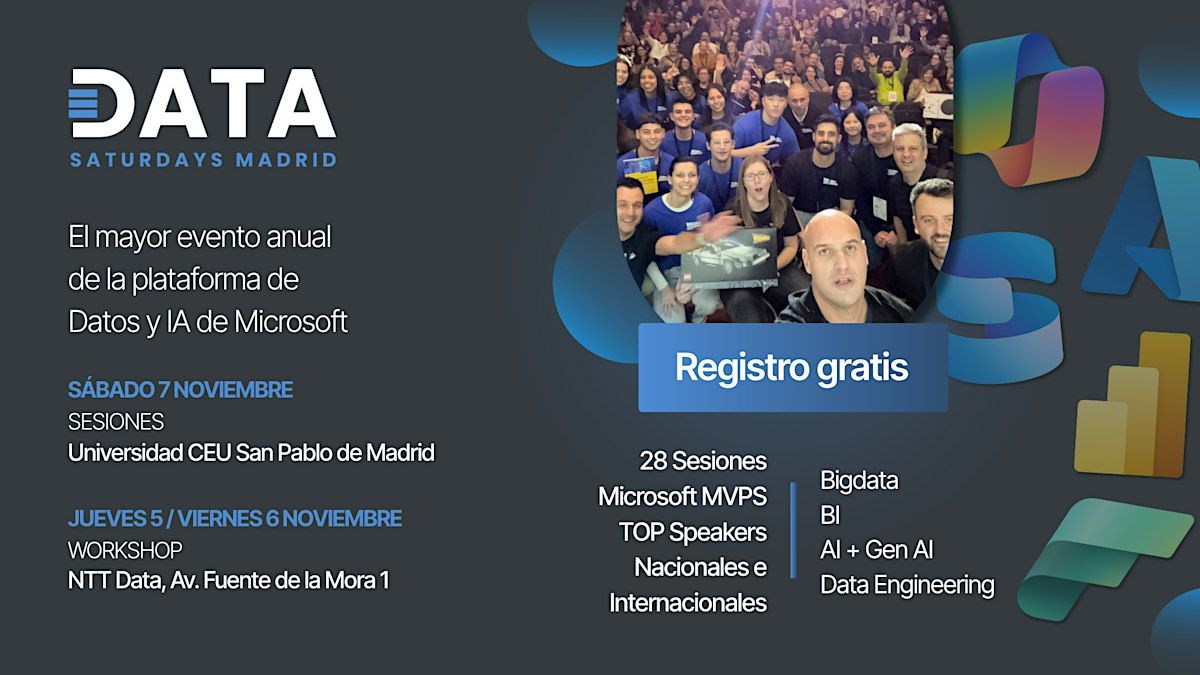
Este evento gratuito (solo 1€ de donación para ONG) es el punto de encuentro para profesionales y futuros expertos en Big Data, SQL, Business Intelligence y AI. Con 42 sesiones en inglés y español, impartidas por MVPs y expertos de Datos e AI con tecnologias Microsoft, te sumergirás en temas como Power BI, Databricks, Motor relacional, Inteligencia Artificial, Gen AI y mucho más. El 7 de noviembre, prepárate para un día lleno de innovación, sesiones exclusivas y todo lo último en tecnología de datos.
Registro aqui: Data Saturday Madrid 2026 (SQLSaturdayMadrid) Entradas, sábado, 7 de noviembre • 8:30 - 19:00 | Eventbrite
¡Y eso no es todo! Sortearemos una consola y otros increíbles premios entre los asistentes. Además, tendrás la oportunidad de hacer networking con los mejores de la industria en un ambiente relajado, acompañado de las ya famosas #sqlbeers. ¡Comparte, inscríbete y forma parte de este evento épico!
Importante, aunque es gratuito el sábado, es obligatorio sacar entrada.
Jueves 5 Nov
🕑: 05:30 PM - 07:30 PM
Build Your Business Context with Microsoft Fabric (2h)
Host: Edgar Cotte
🕑: 05:30 PM - 07:30 PM
Más allá de Power BI: crea tu primera aplicación con Microsoft Fabric (2h)
Host: Iván Arribas
🕑: 05:30 PM - 07:30 PM
Del dato al agente: construye tu Data Agent en Fabric y llévalo a Foundry (2h)
Host: Roberto Navarro
🕑: 05:30 PM - 07:30 PM
Analysing and Resolving Deadlocks (2h)
Host: Erland Sommarskog
🕑: 05:30 PM - 07:30 PM
De entrenar a aprender en contexto: Tabular Foundational models en profundidad
Host: Pau Sempere
Viernes 6 Nov
🕑: 10:00 AM - 02:00 PM
Dime qué commiteas y te diré quién eres (4h)
Host: Mar Lizana
🕑: 10:00 AM - 02:00 PM
DAX a máxima velocidad: Fusion, Callbacks y el tiempo bien modelado
Host: Miguel Egea
🕑: 10:00 AM - 02:00 PM
Crea tu mascota con IA y MicroHarness
Host: Alejandro Almeida
🕑: 10:00 AM - 02:00 PM
T-SQL desde cero: aprende SQL jugando
Host: Roberto Carrancio
🕑: 10:00 AM - 02:00 PM
Quién se está comiendo mi capacidad? Taller práctico de optimización de Fabric
Host: Toni Ferrà
🕑: 03:30 PM - 07:30 PM
Construyendo nuestro primer Lakehouse en Microsoft Fabric
Host: Ana Maria Bisbé York
🕑: 03:30 PM - 07:30 PM
Visuales que enamoran en Power BI: de lo nativo al informe como código
Host: Inés Pascual
🕑: 03:30 PM - 07:30 PM
De modelos a IA gobernada: AI Gateways con Azure API Mgt, Foundry y Databricks
Host: Rodrigo Liberoff
🕑: 03:30 PM - 07:30 PM
SQL Server Perform. Optimization: From Root Cause Analysis to Sustainable Sol.
Host: Torsten Strauß
🕑: 03:30 PM - 07:30 PM
La experiencia como producto
Host: Antonio Soto
Where is it happening?
Event Location & Nearby Stays:
EUR 33.20 to EUR 66.17